llama.cpp 是 GitHub 上累積 130,738 顆星標的開源大型語言模型推論引擎,以 C/C++ 撰寫並採用 MIT 授權。專案於 2026 年 10 月 5 日發布 v0.6.0,加入延伸批次 API、GLM-5.3-Flash 320B 混合模型支援、決策模型專用伺服器端點,以及串接 Hugging Face Hub 的新版 Web UI 下載管線。作為 ggml 生態的核心專案,它在本地端模型部署領域長期扮演基礎設施角色。
llama.cpp 是什麼?
llama.cpp 是以 C/C++ 撰寫的開源 LLM 推論引擎,可在 CPU 與多種 GPU 後端執行量化模型,GitHub 累積 130,738 顆星標,採用 MIT 授權。
專案的官方定位是「在 C/C++ 中進行 LLM 推論」,目標是在各式硬體上以最少的安裝負擔達到領先的推論效能,同時支援本地與雲端環境。它建立在 ggml 張量函式庫之上,採用純 C/C++ 實作且不含外部依賴,這項設計讓它能被編譯進資源受限的裝置,也能以單一執行檔形式部署於伺服器。
專案於 2023 年 3 月建立,由開發者 Georgi Gerganov 發起,其後成為本地推論社群的主要匯聚點。模型權重普遍以 GGUF 格式流通,這種格式由專案與 ggml 生態共同推動,把模型參數、量化資訊與中繼資料封裝於單一檔案,簡化了取得與載入模型的流程。
目標受眾涵蓋需要在私有環境執行模型的開發者、缺乏高階 GPU 的個人使用者,以及把推論能力嵌入產品的團隊。由於支援從 1.5 位元到 8 位元的整數量化,同一份模型可依可用記憶體調整精度與體積,這是它在消費級硬體上被廣泛採用的關鍵前提。
llama.cpp v0.6.0 帶來哪些新功能?
v0.6.0 新增 llama_batch_ext 延伸批次 API、GLM-5.3-Flash 320B 混合模型支援、決策模型端點,並重建內建 Web UI。
本版最核心的變動是延伸批次 API。新增的 llama_batch_ext 與 llama_process() 讓單一批次可同時容納原始詞元與嵌入向量,並支援逐詞元的狀態嵌入,供多詞元預測與深層堆疊類模型使用。官方發布說明指出,範例程式、推測解碼、多模態與伺服器模組皆已陸續遷移至此 API。
模型支援同步擴張。v0.6.0 加入 GLM-5.3-Flash 的完整支援,這是一個 320B 參數的文字與視覺混合模型,採用 KDA 與 DSA 混合架構並結合 MoE 設計;決策模型 Clef 亦取得文字與視覺的完整支援。伺服器端則新增 /v1/systemone 端點,對應 laya、julia-1、lev、openjev 與 kev 等決策模型,並讓 /v1/embeddings 接受具型別的視覺、音訊與影片內容。
內建 Web UI 被重新打造。新版改以 Hugging Face Hub 為資料層,加入模型下載管線與記憶體適配估算,使用者可直接在介面中挑選量化版本、評估是否放得進本機記憶體,再交由伺服器下載與載入。硬體層面則新增 Metal 的張量 API 快閃注意力核心,並為推測解碼與批次解碼加入少列矩陣乘法核心,官方量測在 Apple GPU 上最高約有三倍加速。
llama.cpp 的技術架構有什麼特點?
架構以 ggml 為底層,採零外部依賴的 C/C++ 實作,支援 1.5 至 8 位元量化,並可混合 CPU 與 GPU 推論執行超出顯示記憶體容量的模型。
運算後端的多樣性是它最顯著的特徵。專案支援 CUDA 與 HIP 對應 NVIDIA 與 AMD 顯示卡、Metal 對應 Apple 晶片、Vulkan 與 SYCL 對應跨平台 GPU,另有 CANN、OpenCL、WebGPU、ZenDNN 等針對特定硬體的路徑。這種廣度讓同一套程式碼能在資料中心與個人裝置之間平移,而不必為每個平台重寫推論邏輯。
量化與混合推論是效能取捨的兩大支柱。透過低位元量化,模型體積與記憶體占用可大幅下降,代價是精度損失,使用者需依任務敏感度選擇;而 CPU 與 GPU 混合推論則允許把部分層放在顯示記憶體、其餘留在系統記憶體,使模型規模得以超過單張顯示卡的容量上限。v0.6.0 另加入由模型驅動的 W4A4 乘法路徑,對應 NVFP4 與 MXFP4 等新興低精度格式。
周邊工具鏈則補足實務需求。專案提供命令列介面、相容於 OpenAI 介面的伺服器、語法約束用的 GBNF 文法,以及多模態輸入處理模組;工具與範例皆以同一份核心函式庫為基礎,讓研究驗證與產品部署能共用同一套推論行為。
llama.cpp 的統計數據與授權條件為何?
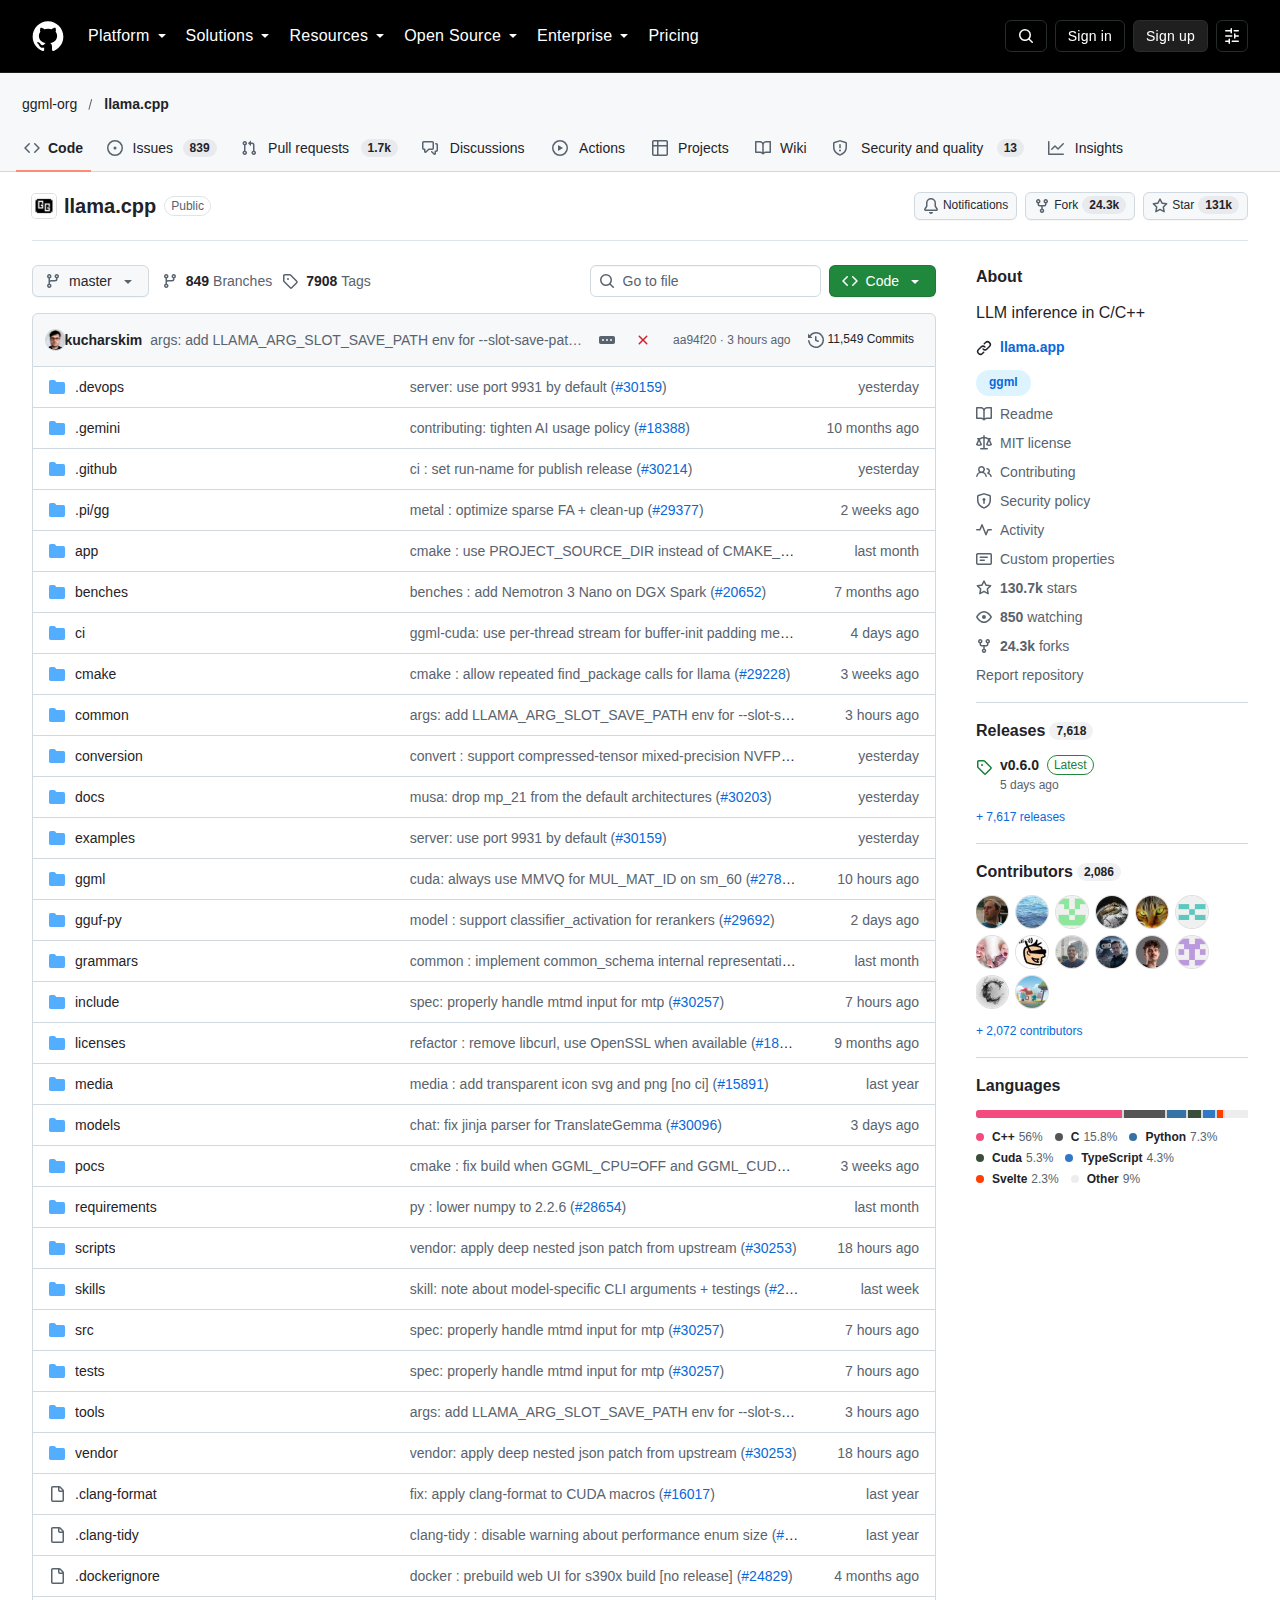
llama.cpp 累積 130,738 顆星標與 24,266 次複製,以 MIT 授權開放,主要語言為 C++,建於 2023 年,累計逾一萬一千次提交與兩千一百位貢獻者。
授權條款屬寬鬆類型。MIT 授權允許使用、修改與再散布,也允許整合進商業產品,僅要求在副本中保留著作權與授權聲明。值得注意的是,官方提供的預先編譯執行檔因打包了 GPLv3+ 授權的元件,整份組合作品須以 GPLv3+ 釋出,但從原始碼自行編譯則不受此限,這對商業整合路徑有實際影響。
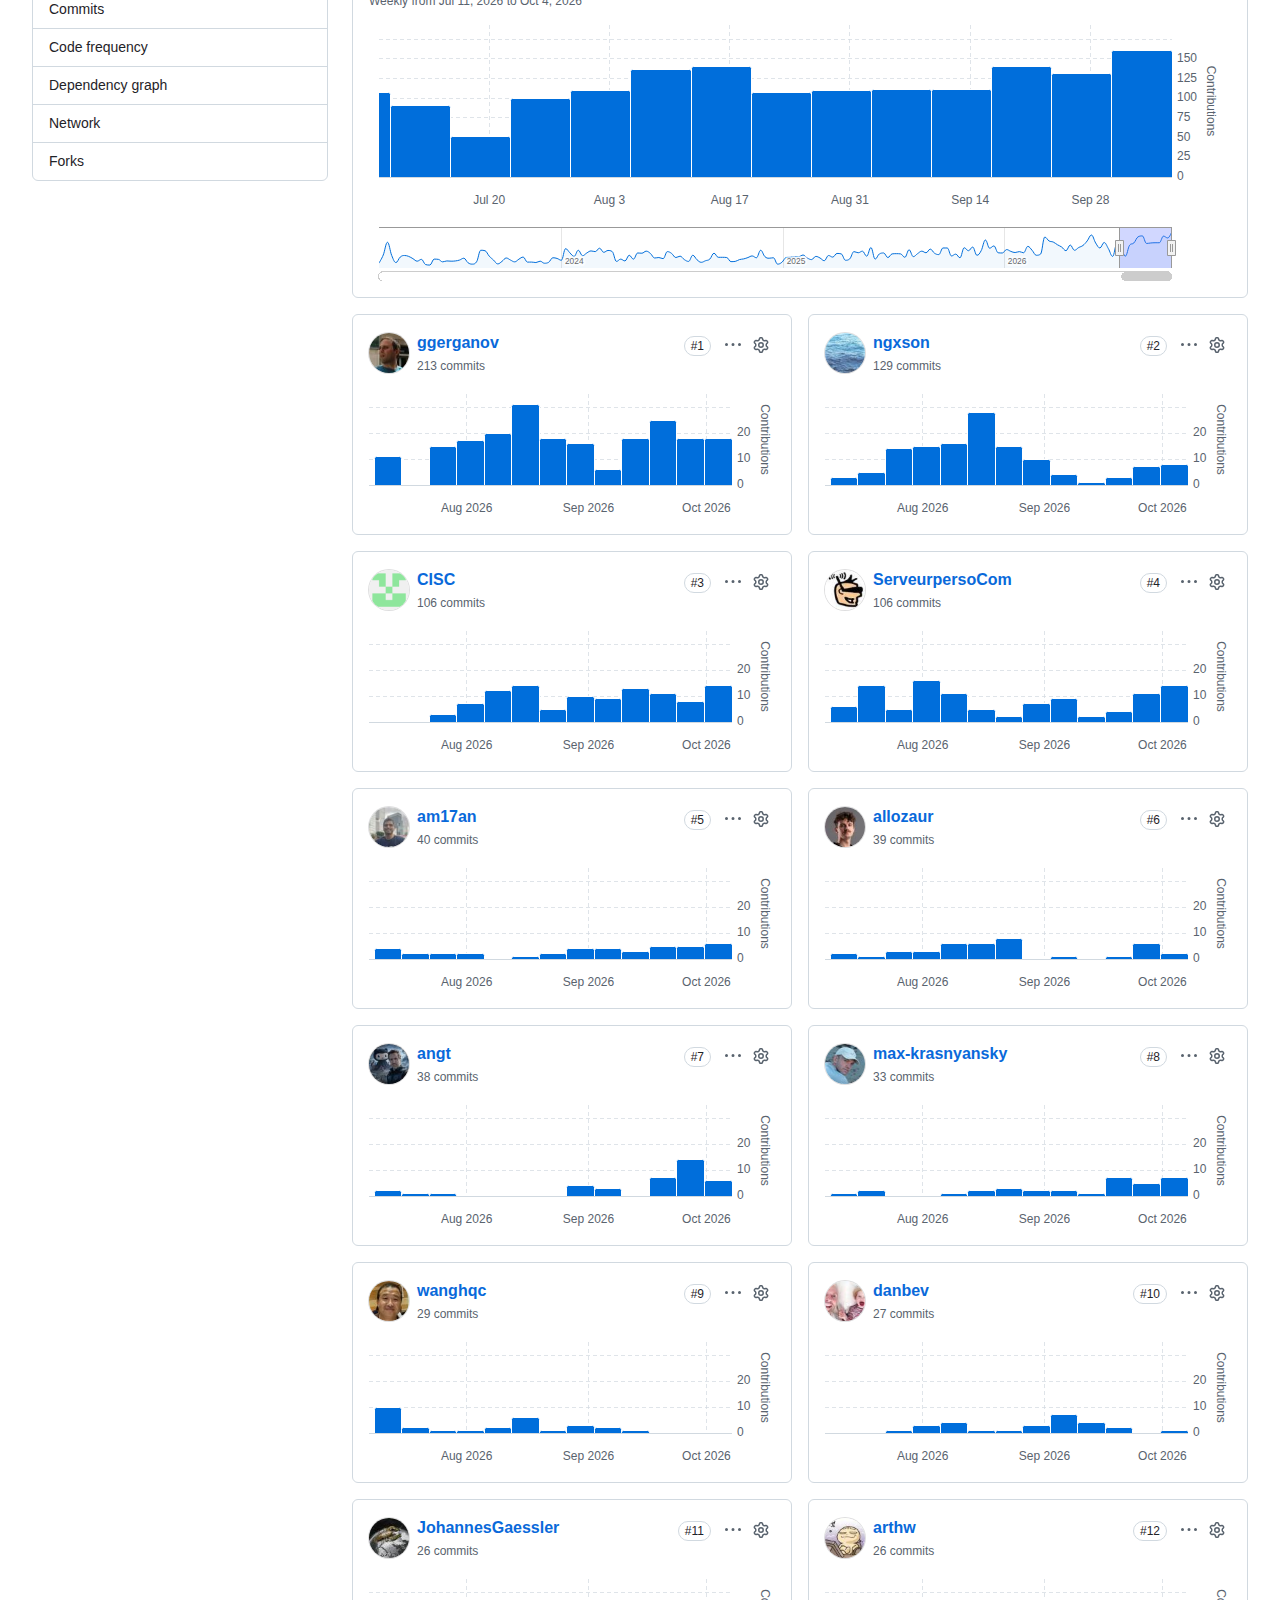
專案活躍度可從提交與發行節奏觀察。儲存庫累計超過一萬一千五百次提交,貢獻者名單逾兩千一百人,目前仍有約 2,512 個未結議題待處理。除了語意化版本的穩定發布,專案同時維持 nightly 建置,最新一筆為 2026 年 10 月 10 日的 b11541,內容涵蓋每日合併的修正與新後端支援。
llama.cpp 在本地推論生態中扮演什麼角色?
llama.cpp 位於本地推論堆疊的底層,許多上層工具以其為引擎;相較於 vLLM 偏重伺服器吞吐、Ollama 偏重易用封裝,它更強調硬體廣度與可嵌入性。
分工上,它與常見方案處於不同層次。Ollama 之類工具把模型取得、服務管理與 API 包裝成單一體驗,底層推論往往仍由其或相容引擎執行;vLLM 專注於資料中心 GPU 上的高吞吐服務,對硬體與部署條件的要求較高;LM Studio 則以桌面圖形介面降低使用門檻。llama.cpp 的定位是通用引擎,強調能跑在最多種硬體上,並且可被嵌入其他應用。
這種底層定位帶來生態上的放大器效應。GGUF 格式與 ggml 已成為跨工具的共同語言,模型發布者通常會同時提供對應的量化檔案;框架與應用則透過其函式庫或伺服器介面接入推論能力。當上游模型架構快速更迭,這個層級的支援速度往往決定整個社群能否即時試用新模型。
商業化路徑相對單純。專案本身不以託管服務或授權費變現,運作依賴社群貢獻與贊助,價值主要體現在降低推論成本與硬體門檻。對企業而言,這種結構意味著採用時少有授權顧慮,但若需要服務保證,仍須自行建立部署與維運能力。
如何快速開始使用 llama.cpp?
可透過官方安裝腳本或 releases 頁面取得執行檔;安裝後以 llama cli 載入量化模型,或以 llama serve 啟動 OpenAI 相容 API 服務。
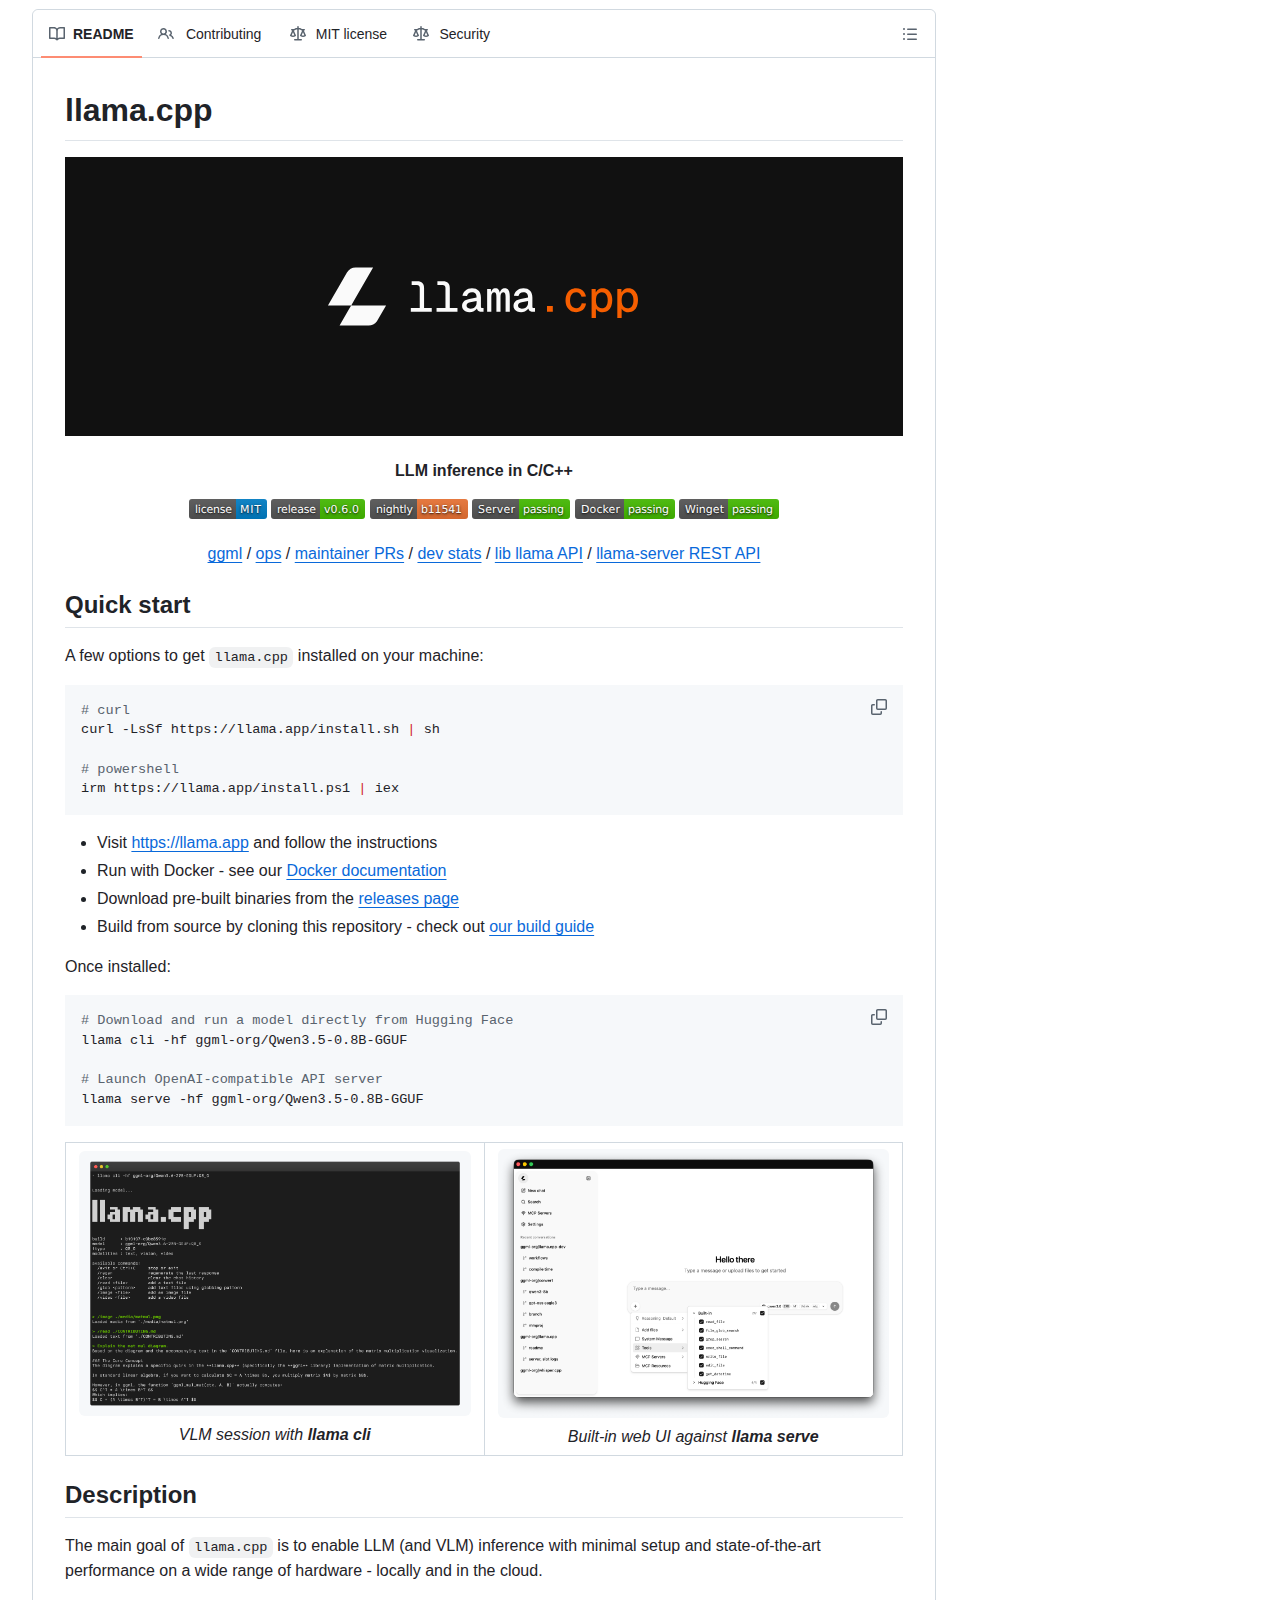
安裝路徑分為三種。最簡便的方式是執行官方安裝腳本,腳本會取得對應平台的執行檔;也可由 releases 頁面下載預先編譯版本,或依建置指南從原始碼編譯以啟用特定後端。官方網站 llama.app 提供各平台的完整說明,Docker 映像亦已提供。
載入與服務則以兩道指令完成。以下範例直接從 Hugging Face 取得量化模型並開始對話,或啟動相容於 OpenAI 介面的伺服器,供既有應用接入:
# 下載並執行模型
llama cli -hf ggml-org/Qwen3.5-0.8B-GGUF

# 啟動相容 OpenAI 的 API 伺服器
llama serve -hf ggml-org/Qwen3.5-0.8B-GGUF
實務上建議先確認記憶體條件。若模型無法完整放入顯示記憶體,可調整卸載至 GPU 的層數,改以 CPU 與 GPU 混合方式執行;量化位元越低,體積與記憶體需求越小,但精度亦隨之下降,需依任務容忍度取捨。
出處連結有哪些?
本文資訊整理自 ggml-org/llama.cpp 的 GitHub 儲存庫與官方版本發布說明,涵蓋專案定位、技術架構、版本更新、統計數據與授權條件。
- GitHub 儲存庫:https://github.com/ggml-org/llama.cpp
- 官方網站:https://llama.app
- v0.6.0 發布說明:https://github.com/ggml-org/llama.cpp/releases/tag/v0.6.0
- nightly 建置:https://github.com/ggml-org/llama.cpp/releases
- ggml 函式庫:https://github.com/ggml-org/ggml
- 伺服器文件:https://github.com/ggml-org/llama.cpp/blob/master/tools/server/README.md
- 建置指南:https://github.com/ggml-org/llama.cpp/blob/master/docs/build.md
- MIT 授權條款:https://github.com/ggml-org/llama.cpp/blob/master/LICENSE
總結:llama.cpp 適合什麼團隊?
llama.cpp 適合需要在多種硬體上執行本地模型、重視部署自由度與授權寬鬆度的團隊;若追求極致伺服器吞吐或免設定體驗,宜評估其他方案。
llama.cpp 的價值在於把推論能力下放到幾乎所有硬體。透過零外部依賴的 C/C++ 實作、1.5 至 8 位元量化與橫跨 CPU、Apple Silicon 及多家 GPU 後端,它讓模型部署不必以高階加速卡為前提;v0.6.0 的延伸批次 API 與 320B 級混合模型支援,則顯示專案仍持續吸收前沿模型架構。
採用前仍須衡量現實條件。硬體後端眾多意味著效能表現高度取決於平台與編譯選項,團隊需要具備對應的調校能力;nightly 建置雖帶來即時支援,也增加版本控管負擔,產品應以穩定版本為基準並建立迴歸測試流程。MIT 授權讓整合路徑相對單純,但預編譯執行檔的授權組合差異,仍需在商業部署前確認。適合與否,最終取決於團隊在硬體廣度、部署成本與維護投入之間的取捨。